Bỏ qua, đến nội dung chính
hungdv

Đoàn Việt Hưng · Kỹ sư AI / Thị giác máy tính

Mình xây hệ thống thị giác máy tính chạy được ngoài đời thật.

Kỹ sư thị giác máy tính tại Việt Nam. Phát hiện lỗi công nghiệp, nhận dạng khuôn mặt và biển số, đọc tài liệu, đo đạc bằng camera.

Chi tiết dự án

Kiểm tra lỗi bề mặt bằng camera line-scan

Mã nguồn riêng tư

Hệ thống phát hiện bất thường chỉ cần học từ ảnh đạt chuẩn, không cần ảnh lỗi. Mỗi ảnh trả về OK hoặc NOK, bản đồ bất thường, mask và khung quanh vùng nghi lỗi.

Kết quả

Kết quả trên tập kiểm thử 133 ảnh (26 lỗi, 107 tốt). README ghi các số độ trễ là kết quả lịch sử.

Recall
24/26 (92,3%)
133 ảnh kiểm thử: 26 lỗi, 107 tốt
Báo nhầm
3/107 (2,8%)
cùng tập kiểm thử
Độ trễ P50
43 ms
RTX A4000, FP16, batch 15, 3.990 frame liên tục; P95 là 44 ms
Trên CPU
≈ 683 ms
OpenVINO FP32, 2 × Xeon Gold 6138

Bài toán

Lỗi quá hiếm và đa dạng để gom ảnh huấn luyện, trong khi dây chuyền cần quyết định cho mỗi ảnh trong khoảng 50 ms.

Cách làm

  • PatchCore với MobileNetV3-Large (FP16), memory bank xây từ chỉ 10 ảnh đạt chuẩn.
  • Mỗi ảnh 1024 × 1792 được cắt tile, chấm điểm, ghép thành một bản đồ bất thường và so ngưỡng hiệu chuẩn trên 50 ảnh đạt chuẩn khác.
Chi tiết triển khai
  • Đặc trưng lấy ở blocks.4 và blocks.6. Tile 448 px, chồng lấn 0,20; memory bank dùng coreset 0,10.
  • Điểm các tile được ghép bằng cửa sổ Hann, làm mượt Gaussian, chuẩn hóa theo thống kê của ảnh đạt chuẩn và giới hạn trong ROI.
  • Dashboard vận hành bằng aiohttp và React 19 (TypeScript, Vite, shadcn/ui), lịch sử lưu SQLite, nhận ảnh từ camera Basler qua pypylon. Tab Train & Setup cho phép tạo sản phẩm mới, tải ảnh đạt chuẩn, huấn luyện và kích hoạt ngay trên trình duyệt.

Bài học triển khai

  1. 1.Camera line-scan kích hoạt theo encoder chỉ xuất ảnh khi bàn quay. Không có frame lúc motor đứng yên là hành vi đúng, không phải lỗi mạng.
  2. 2.Cáp camera cắm qua cổng PLC chỉ chạy 100 Mbps. Ở khoảng 64 Mbit/s thì ổn; tăng tốc độ bàn lên gần 98 Mbit/s là bắt đầu mất frame.
Phương pháp đánh giá

Các thí nghiệm few-shot trong ngân sách 10 hoặc 15 ảnh đạt chuẩn được chạy qua 8 seed, kiểm chứng lồng nhau (nested leave-one-out), cho ra 160 điểm vận hành.

Kết luận được ghi lại cả khi cấu hình mới không tốt hơn, ví dụ: chưa có cấu hình nào cải thiện đồng thời recall và tỉ lệ báo nhầm. Ghi cả kết quả âm giúp lần thử sau không lặp lại hướng đã thất bại.

Bài viết đầy đủ về thí nghiệm few-shotMười ảnh đạt chuẩn đủ cho mô hình, chưa đủ cho ngưỡng

Công nghệ

  • PyTorch
  • PatchCore
  • MobileNetV3
  • FP16
  • OpenVINO
  • aiohttp
  • React 19
  • TypeScript
  • SQLite
  • pypylon

IntelliDoc OCR: số hóa văn bản hành chính tiếng Việt

Mã nguồn riêng tư

Hệ thống nhận PDF, trích xuất nội dung bằng OCR, để người rà soát sửa và phê duyệt từng trường, rồi lưu bằng chứng để kiểm tra lại về sau.

Kết quả

Ba chế độ xử lý; phân đoạn hồ sơ gộp có bước người xác nhận ranh giới; vẽ crop thủ công làm bằng chứng; nhật ký kiểm toán.

Theo dõi job, chi phí OCR và System Monitor; giao diện VI/EN. Tối đa 15 PDF mỗi job, tổng 200 MiB.

Trang đã xử lý
237
66 PDF trong 6 job, lần chạy thử nội bộ 07/2026
Trang lỗi
0
cùng lần chạy, sau khi tự thử lại
Lượt gọi OCR
137/137
đều thành công, ghi đủ usage
Trường có bằng chứng
544/660
trường trích xuất có bbox và ảnh crop làm bằng chứng (82%)

Trạng thái: Hoàn tất hai milestone, đang thử nghiệm nội bộ, chưa phải bản phê duyệt cho khách hàng. Chưa đo độ chính xác từng trường so với ground truth.

Bài toán

Tài liệu có nhiều bố cục khác nhau, và khi OCR sai thì người sửa phải để lại dấu vết truy được.

Cách làm

  • Giao diện Next.js; FastAPI nhận job; Celery và Redis chạy hàng đợi; Nginx đứng trước; tất cả chạy trong Docker Compose.
  • Endpoint OCR tương thích OpenAI do máy chủ cấu hình; khóa và URL không bao giờ xuống trình duyệt. Có hộp xác nhận khi endpoint nằm ngoài hệ thống.
Chi tiết triển khai
  • Đăng nhập bằng mật khẩu băm, phiên ký bằng khóa bí mật. Kết quả lưu thành JSON, PDF và artifact theo từng job; Redis chỉ làm hàng đợi.

Công nghệ

  • Next.js
  • FastAPI
  • Celery
  • Redis
  • Nginx
  • Docker Compose

Vision Measurement Toolkit: đo khoảng cách và tốc độ từ camera

Mã nguồn mở · Xem mã nguồn trên GitHub

Bộ công cụ gộp hiệu chuẩn camera, đo khoảng cách trên mặt phẳng, đo 3D bằng ước lượng độ sâu từ một camera và đo tốc độ xe theo làn.

Kết quả

Ba ứng dụng dòng lệnh: đo khoảng cách và chiều cao, đo độ sâu realtime, đo tốc độ theo làn.

Hai repo thử nghiệm riêng (Distance_calculation, Velocity_detection) được tái cấu trúc thành một package có test.

Hình học
49 FPS
MAPE khoảng cách 13,34%; homography + YOLO; Intel Core i7, GTX 1650 Ti
Deep learning
> 230 FPS
tốc độ hiển thị, MAPE 15,07%; Depth Anything V2 chạy ở worker riêng; cùng máy

Bài toán

Muốn ra mét từ ảnh 2D thì phải biết một pixel ứng với bao nhiêu mét, và con số đó thay đổi theo khoảng cách tới camera.

Cách làm

  • Homography từ mặt phẳng đường sang ảnh; hiệu chuẩn camera bằng bàn cờ; giữ ổn định hiệu chuẩn bằng optical flow.
  • Phát hiện bằng YOLO, ước lượng độ sâu bằng Depth Anything; hai bên chạy ở worker độc lập để không chặn nhau. Chọn mục tiêu bằng cú nhấp chuột và theo dõi bằng KCF.
Chi tiết triển khai
  • Phần tốc độ có script đối chiếu với dữ liệu ground truth.

Công nghệ

  • OpenCV
  • Homography
  • YOLO
  • Depth Anything
  • KCF
  • Python

Giám sát an toàn lao động bằng pipeline nhiều tầng

Mã nguồn riêng tư

Pipeline sáu tầng phát hiện và theo dõi người, kiểm tra mũ, áo phản quang, khẩu trang, găng tay và các hành vi như dùng điện thoại trên luồng video realtime. Luật vùng cấm cảnh báo khi có người đi vào khu vực hạn chế.

Kết quả

Cùng một mã nguồn chạy ở web realtime, RTSP và CLI batch.

Các model PyTorch được xuất sang ONNX để chạy bằng ONNX Runtime; riêng găng tay chạy TFLite trên CPU.

Trạng thái: Chưa đánh giá định lượng: chưa đo FPS hay độ chính xác từng tầng trên phần cứng cố định.

Bài toán

Mũ và áo thấy được trên toàn khung hình, nhưng khẩu trang và găng tay cần ảnh cắt vùng mặt, vùng tay; chạy mọi model trên cả khung hình thì vừa chậm vừa nhiễu.

Cách làm

  • Sáu tầng: phát hiện và theo dõi người → PPE (mũ, áo) → tách vùng (đầu-mặt, tay, thân) → khẩu trang → găng tay → hành vi.
  • Mỗi người được cắt thành các vùng rồi mới đưa vào model phân loại tương ứng. Kết quả khẩu trang và găng tay lưu theo track_id và làm mới theo chu kỳ để giảm tải.
Chi tiết triển khai
  • Nhánh PPE và nhánh hành vi chạy song song trên khung hình gốc, không phụ thuộc bước tách vùng.
  • Vùng cấm là đa giác vẽ trên khung hình camera; người đang được theo dõi bị đánh dấu khi đứng trong vùng đó.

Công nghệ

  • PyTorch
  • ONNX Runtime
  • TFLite
  • Tracking
  • RTSP

Mũ và áo phản quang trong nhà xưởng

Kết quả pipeline trên một clip công khai từ YouTube, không phải hiện trường khách hàng.

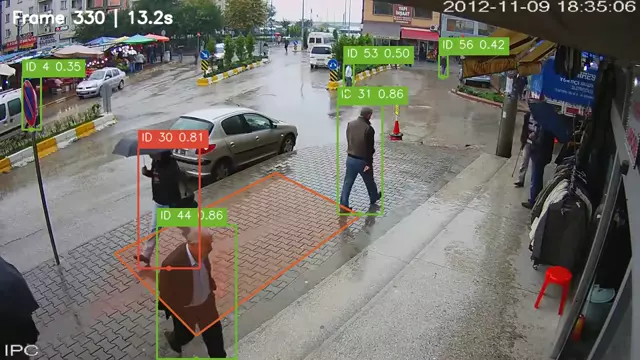
Vùng cấm

Camera đường phố từ một clip công khai trên YouTube. Người chuyển sang khung đỏ khi đứng trong vùng màu cam.

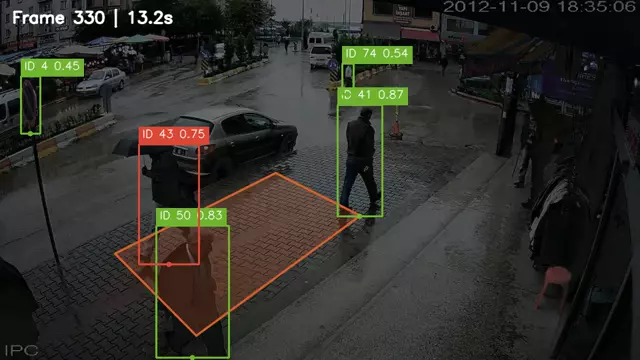
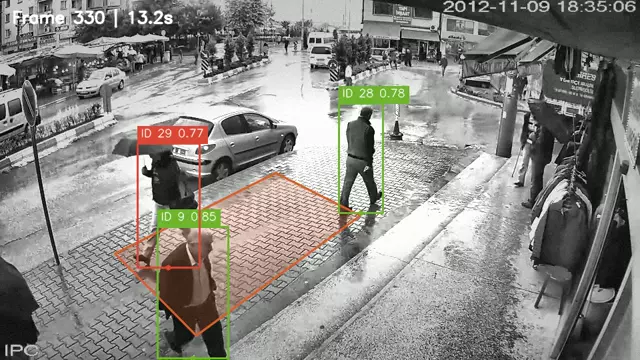
Cùng khung hình, ba điều kiện ánh sáng

  • GốcGốc
  • Làm tối (ban đêm)Làm tối (ban đêm)
  • Đen trắng (hồng ngoại)Đen trắng (hồng ngoại)
Bản làm tối và bản đen trắng được tạo từ cùng clip để thử độ bền. Cảnh báo vùng cấm vẫn bật ở cả ba, nhưng ID theo dõi khác nhau (30, 43, 29), nên tracking chưa đồng nhất giữa các điều kiện.

Lĩnh vực làm việc

Ngoài bốn dự án trên, mình làm việc với các bài toán sau.

Nhận dạng khuôn mặt
Chọn và benchmark detector, landmark và embedding cho điều kiện triển khai thực tế.
Chống giả mạo khuôn mặt
Phân biệt khuôn mặt thật với ảnh in hoặc màn hình phát lại trước khi nhận dạng.
Nhận dạng biển số (ALPR)
Benchmark trên biển số Việt Nam và pipeline nhiều camera.
Phát hiện bất thường công nghiệp
Học từ ảnh đạt chuẩn và chạy trong khuôn khổ thời gian của dây chuyền.

Mối quan tâm nghiên cứu

Những câu hỏi mình gặp khi triển khai và muốn đào sâu hơn:

  1. Q1Phát hiện bất thường còn đáng tin đến đâu khi chỉ có vài ảnh đạt chuẩn, và làm sao đánh giá trung thực trong ngân sách dữ liệu nhỏ như vậy?
  2. Q2Làm sao chọn và giữ điểm vận hành cân bằng giữa recall và tỉ lệ báo nhầm khi dữ liệu trên dây chuyền trôi dần theo thời gian?
  3. Q3Mô hình chống giả mạo khuôn mặt cần gì để tổng quát qua nhiều loại camera và thiết bị tấn công chưa thấy khi huấn luyện?
  4. Q4Đo lường từ một camera duy nhất có thể chính xác đến đâu, và sai số nên được ước lượng, báo cáo ra sao?

Kinh nghiệm

HPT Vietnam Corporation

  • Thực tập sinh · 07/2025 – 11/2025
  • AI – Computer Vision Solution Engineer · 12/2025 – nay
  • Đóng góp vào nền tảng thị giác AI cho an ninh và vận hành của công ty: nhận diện khuôn mặt, chống giả mạo khuôn mặt, nhận dạng biển số (ALPR) và nhận diện đồ bảo hộ lao động (PPE). Đồng tác giả trong chứng nhận sở hữu trí tuệ của nền tảng này.
  • Thiết kế và triển khai các hệ thống giám sát AI dạng POC trên nhiều luồng camera RTSP (H.264), chạy trên thiết bị biên có GPU NVIDIA.
  • Tối ưu pipeline suy luận realtime bằng ONNX Runtime và CUDA để giảm độ trễ và giữ ổn định khi xử lý nhiều luồng trên phần cứng giới hạn.
  • Đóng gói model và dịch vụ backend bằng Docker để triển khai on-premise lặp lại được cho khách hàng doanh nghiệp, trong đó có các thương hiệu lớn ngành thực phẩm và đồ uống.
  • Làm việc trực tiếp với các bên liên quan để chuyển yêu cầu nghiệp vụ thành kiến trúc hệ thống AI, cân bằng độ chính xác và độ trễ cho từng bài toán thực tế.

Học vấn

Trường Đại học Khoa học Tự nhiên, ĐHQG-HCM

Cử nhân Khoa học Máy tính, chuyên ngành Thị giác máy tính · 10/2021 – 10/2025

Ngôn ngữ: tiếng Việt (bản ngữ), tiếng Anh (làm việc chuyên nghiệp).

Thành tích và chứng chỉ

  • Đồng tác giả, chứng nhận sở hữu trí tuệ cho một nền tảng thị giác AI phục vụ an ninh và vận hành.
  • Chứng chỉ Getting Started with Deep Learning.

Liên hệ

Nếu bạn đang tìm người làm thị giác máy tính từ thí nghiệm đến triển khai, hoặc muốn trao đổi về các hướng nghiên cứu ở trên, hãy liên hệ với mình.